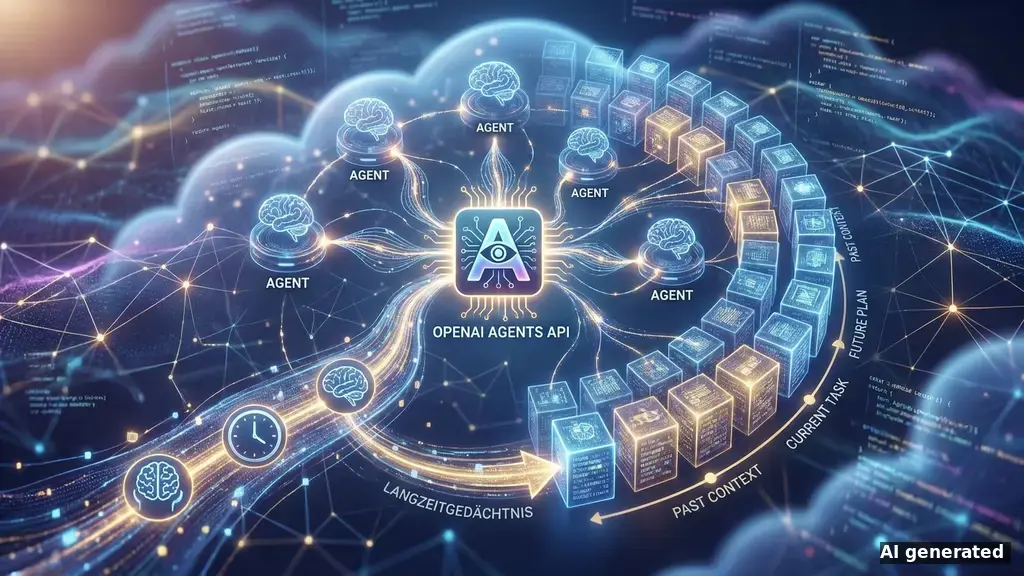
Die neue OpenAI Agents API orchestriert komplexe Cloud-Agenten und übernimmt das State-Management innerhalb laufender Sessions.
Das System nutzt den Codex-Harness für das Kontextmanagement, bietet aber kein integriertes Langzeitgedächtnis über mehrere Sitzungen hinweg.
Die API ist ab sofort verfügbar, erfordert für persistente Nutzerdaten und Personalisierung jedoch den Einsatz externer Datenbank-Architekturen durch die Entwickler.
OpenAI, der Entwickler von ChatGPT, hat mit der neuen OpenAI Agents API einen Managed Service für die Orchestrierung autonomer Cloud-Agenten veröffentlicht, der Entwicklern das aufwendige State-Management abnimmt. Wie OpenAI mitteilte, basiert die Infrastruktur auf dem bewährten Codex-Harness und ermöglicht langlaufende Nutzersitzungen sowie den flexiblen Einsatz externer Tools. Die API richtet sich an Entwickler, die komplexe KI-Workflows in der Cloud bauen wollen, erfordert für ein echtes Langzeitgedächtnis über mehrere Sessions hinweg jedoch weiterhin externe Speicherlösungen.
Die Neuerungen im Detail
Die neue OpenAI Agents API zielt darauf ab, die Entwicklung von KI-Agenten drastisch zu vereinfachen. Laut der offiziellen Dokumentation übernimmt das System das State-Management im Hintergrund. Ein zentrales technisches Detail ist dabei das Session-Management: Die API komprimiert automatisch den Kontext, sobald eine Session ihr Token-Limit erreicht.
Das offizielle OpenAI Agents SDK speichert die Konversationshistorie standardmäßig in einer In-Memory-Datenbank, die exakt an 1 spezifische Session gebunden ist. Endet der Prozess, gehen diese Daten verloren.
Die OpenAI Agents API bietet ein hervorragendes Kurzzeit-Kontextmanagement für laufende Sessions, liefert aber out-of-the-box keine persistente Datenbank für nutzerspezifische Fakten.
Zwar bietet OpenAI ein separates Sandbox-Memory-Konzept an, damit zukünftige Agenten-Durchläufe aus vorherigen Fehlern lernen können. Dieses ist laut Dokumentation jedoch strikt vom konversationellen Session-Gedächtnis getrennt. Entwickler, die agentenbasierte Anwendungen bauen, müssen den Status zwischen verschiedenen Aufgaben zwingend über eigene Speicherlösungen verwalten.
Warum das wichtig ist
Diese Architektur-Entscheidung hat massive Auswirkungen auf die Praxis. Obwohl die API für langlaufende Workflows konzipiert wurde, „vergisst“ der Agent ohne eine selbstgebaute Persistenzschicht alle nutzerspezifischen Fakten zwischen zwei Sessions. Laut Diskussionen in der OpenAI-Community und auf GitHub fehlt Entwicklern eine native, pro Nutzer funktionierende Langzeitgedächtnis-Funktion. Im GitHub-Issue #887 fasst die Community es treffend zusammen: „Langzeitgedächtnis ist in der OpenAI API nicht verfügbar.“
Entwickler von Produktionssystemen müssen daher selbst entscheiden, wie sie Personalisierung, Konfliktauflösung und Datenaufbewahrungsrichtlinien umsetzen. Das offizielle OpenAI-Cookbook empfiehlt hierfür lokale State-Objekte und Techniken wie Memory-Destillation.
Dies hat einen rasant wachsenden Markt für Drittanbieter geschaffen. Mindestens 4 spezialisierte Tools (darunter Mem0, Kit for AI und Hindsight) positionieren sich explizit als die fehlende Langzeitgedächtnis-Schicht für OpenAI-Agenten. Die Entwickler-Community greift zunehmend auf Vektordatenbanken und SQLite-ähnliche Speicher zurück, um diese Lücke zu schließen. Wer autonome Agenten für den produktiven Einsatz plant, muss wissen: Die Orchestrierung übernimmt OpenAI, das Gedächtnis bleibt Entwicklersache.
Verfügbarkeit & Fazit
Die OpenAI Agents API und das zugehörige SDK sind ab sofort für Entwickler nutzbar. Die Abrechnung erfolgt nutzungsbasiert über die regulären API-Kosten der zugrundeliegenden Modelle.
Während OpenAI mit der neuen API die Orchestrierung und das Tool-Calling von Cloud-Agenten auf ein neues Level hebt, bleibt die Implementierung eines echten, sitzungsübergreifenden Langzeitgedächtnisses die größte architektonische Herausforderung für Entwickler.
FAQ
Was bedeutet die OpenAI Agents API für Entwickler?
Die API vereinfacht den Bau komplexer KI-Agenten erheblich, da OpenAI das State-Management und die Tool-Orchestrierung innerhalb einer Session übernimmt. Entwickler können sich auf die Kernlogik konzentrieren, müssen für sitzungsübergreifende Personalisierung jedoch eigene Datenbanken anbinden.
Hat die OpenAI Agents API ein eingebautes Langzeitgedächtnis?
Nein. Die API bietet lediglich ein intelligentes Kurzzeit-Kontextmanagement, das ältere Informationen innerhalb einer laufenden Session komprimiert. Sobald die Session beendet wird, gehen die Daten der In-Memory-Datenbank verloren, sofern sie nicht extern gespeichert wurden.
Wie speichern Entwickler Nutzerdaten über mehrere Sessions hinweg?
Laut dem offiziellen OpenAI-Cookbook müssen Entwickler externe Speicherlösungen wie Vektordatenbanken oder spezialisierte Drittanbieter-Tools (z.B. Mem0 oder Kit for AI) nutzen. Diese fungieren als externe Gedächtnisschicht, aus der relevante Fakten bei Bedarf in den Prompt geladen werden.
Florian Schröder ist Gründer von AI Rockstars, KI-Stratege und Prompt Engineer. Er berät Unternehmen bei der praktischen Implementierung von generativer KI und Automation.
Wir verwenden Technologien wie Cookies, um Geräteinformationen zu speichern und/oder darauf zuzugreifen. Wir tun dies, um das Surferlebnis zu verbessern und um personalisierte Werbung anzuzeigen. Wenn Sie diesen Technologien zustimmen, können wir Daten wie das Surfverhalten oder eindeutige IDs auf dieser Website verarbeiten. Wenn Sie Ihre Zustimmung nicht erteilen oder zurückziehen, können bestimmte Funktionen beeinträchtigt werden.
Funktional
Immer aktiv
Die technische Speicherung oder der Zugang ist unbedingt erforderlich für den rechtmäßigen Zweck, die Nutzung eines bestimmten Dienstes zu ermöglichen, der vom Teilnehmer oder Nutzer ausdrücklich gewünscht wird, oder für den alleinigen Zweck, die Übertragung einer Nachricht über ein elektronisches Kommunikationsnetz durchzuführen.
Vorlieben
Die technische Speicherung oder der Zugriff ist für den rechtmäßigen Zweck der Speicherung von Präferenzen erforderlich, die nicht vom Abonnenten oder Benutzer angefordert wurden.
Statistiken
Die technische Speicherung oder der Zugriff, der ausschließlich zu statistischen Zwecken erfolgt.Die technische Speicherung oder der Zugriff, der ausschließlich zu anonymen statistischen Zwecken verwendet wird. Ohne eine Vorladung, die freiwillige Zustimmung deines Internetdienstanbieters oder zusätzliche Aufzeichnungen von Dritten können die zu diesem Zweck gespeicherten oder abgerufenen Informationen allein in der Regel nicht dazu verwendet werden, dich zu identifizieren.
Marketing
Die technische Speicherung oder der Zugriff ist erforderlich, um Nutzerprofile zu erstellen, um Werbung zu versenden oder um den Nutzer auf einer Website oder über mehrere Websites hinweg zu ähnlichen Marketingzwecken zu verfolgen.